Dr. Lu专栏|AI上线,不是结束,是刚开始
编者按:
生成式 AI 出现后,各行各业的企业都在积极拥抱AI。很多企业已经做到了“AI能干活”,却在上线后慢慢失去了它。这篇讲一个被系统性低估的话题:AI应用系统的运营。希望还没有意识到AI系统运营重要性的企业,可以从建设期就开始考虑系统上线后的运营问题。前人已经踩过的坑,尽量避免重蹈覆辙。
生成式AI出现后这几年,用户企业的讨论重点几乎全部集中在“怎么把AI应用系统建起来”:建设部署垂域大模型、上智能体平台、选试点场景开发应用、组织员工创新大赛鼓励参与。但有一个话题,始终在聚光灯外:建完之后呢?
《周易》六十四卦,以“未济”作结——尚未渡过。它不但没有以“完成”收尾,甚至留了四个字警告后人:“初吉终乱”——开始都吉,停下来,就乱了。完成从来不是终点,只是另一种开始。
AI也不例外。完成建设,距离成功还很远。全球企业已经向生成式AI投入数百亿美元,MIT的跟踪研究显示,95%的组织没有看到实质回报;Gartner预测,超过40%的Agentic AI项目将在2027年底前被取消。在工业领域,我们见过太多这样的故事:试点时效果惊艳,验收时掌声热烈,半年之后再去看,系统还挂在服务器上,却已经没有人真正在用它。
一个越来越清晰的现实是:AI系统大多不是战死的,是饿死的。
先看AI系统上线之后,到底会发生什么。以我这几年的观察,问题集中在四类。
数据链路中断。上游系统的字段改了、采集设备故障了、网络分区了,数据悄悄断了,模型还在跑,只是吃进去的已经不对。
算法效果漂移。世界在变:设备在老化,控制系统升级了,不同批次原材料成分变了,而模型还停留在训练那一天的世界上。机器学习有个写进教科书三十年的规律:输入与结果的关系会随时间漂移,模型不会自动适应。
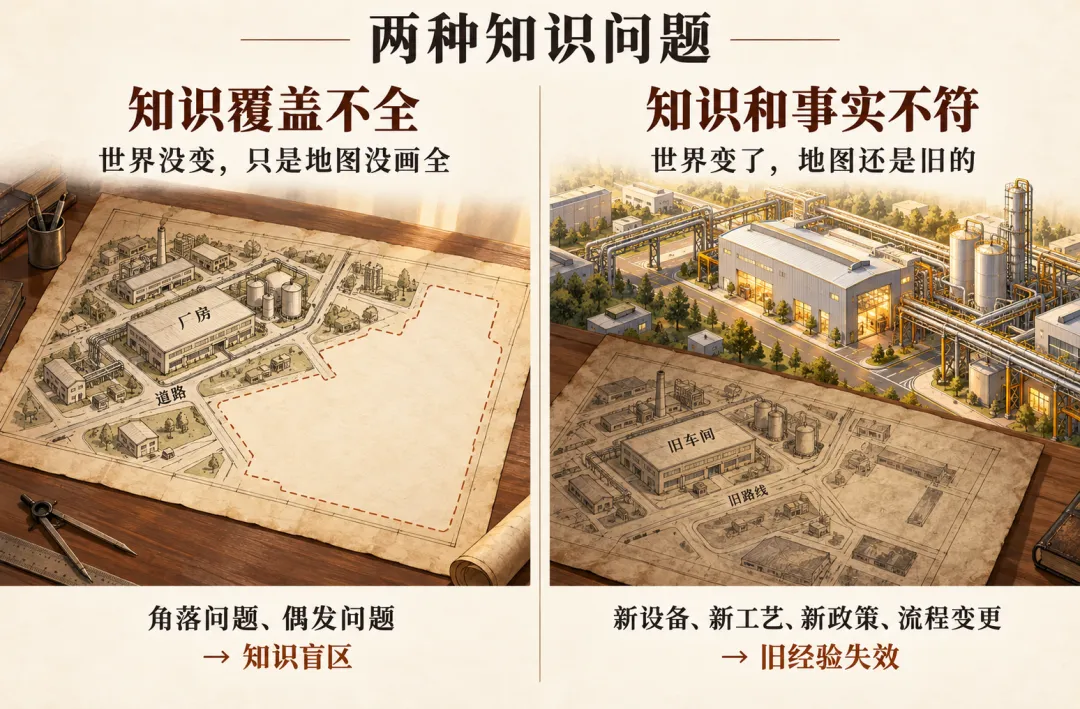
知识覆盖不全。遇到建设期没有调研到的角落问题和偶发问题,世界没变,只是地图没画全。AI赖以判断的知识库存在盲区,一问就露馅。
知识和事实不符。上线了新设备、新工艺,发布了新政策,变更了工作流程,世界变了,地图还是旧的。知识库里那条“老经验”,在新世界里已经不成立,AI按旧知识做判断,错得理直气壮。
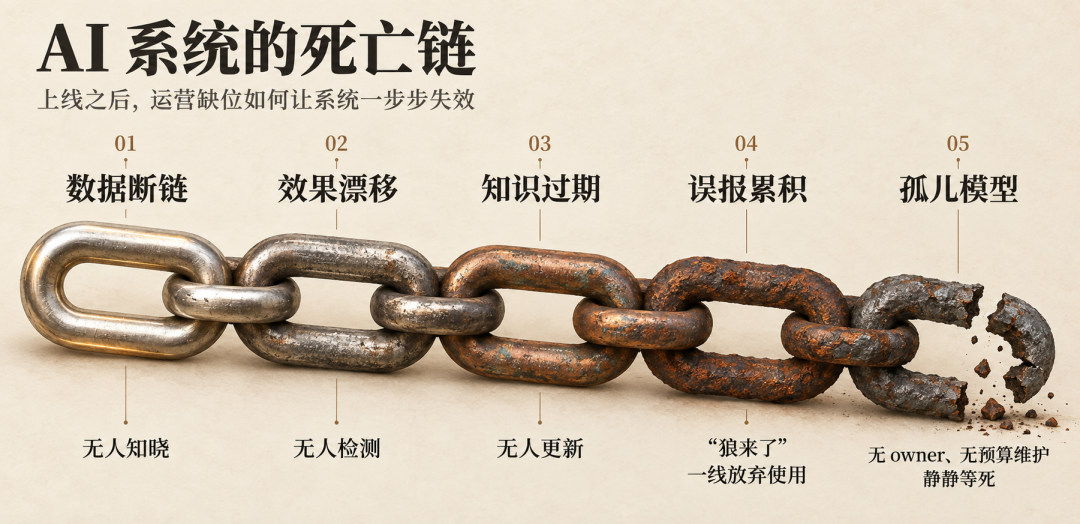
四类问题,最后汇成同一条死亡链:数据断链,无人知晓→效果漂移,无人检测→知识过期,无人更新→误报累积,“狼来了”效应让一线放弃使用→最终,系统成为一个没有owner、没有预算维护、静静等死的孤儿。
医疗行业有个代价高昂的案例:某著名公司的败血症预测模型曾被数百家医院采用,到几年后再验证,发现它漏报了约三分之二的败血症患者、产生大量假警报,预警的可靠度已经低到让一线医生事实上放弃使用。互联网行业也有:一家知名公司的房价预测模型直接驱动买卖决策,市场波动下模型失效又没有熔断机制,最终业务关闭、数亿美元损失。
这条死亡链上的每一环,没有一个是技术问题。能够上线应用,技术可行性已经得到证明;导致死亡的,都是上线后的运营不到位。
说到这里,我必须先澄清一个可能的误解:运营,不是AI时代才出现的新问题。
回想一下。企业上ERP、上MES、上 CRM 的时候,有谁质疑过“上线之后要配运维团队”吗?没有。系统要养,天经地义。
互联网时代,网站和App上线后配内容运营、用户运营、产品迭代,“上线只是开始”是整个行业的基本常识。
机器学习兴起后,这个老问题换了一副新面孔。Google 的工程师团队在 2015 年发表了一篇题为《机器学习系统中的隐性技术债》(Hidden Technical Debt in Machine Learning Systems)的影响深远的论文,指出真实的机器学习系统里,模型代码只是其中一小块,四周被数据管道、监控、基础设施层层包围;他们还提出了一条原则:改任何东西,都在改变一切。也就是说,机器学习系统是一种会腐烂的资产。世界在变,它必须跟着变,否则就在悄悄失准。
此后十余年,业界为这件事发明了一连串名词:管模型和数据链路的MLOps,管模型资产治理的ModelOps,管prompt、知识库和成本运维的LLMOps,管数字员工行为的AgentOps。每一次更名,都在提醒同一件事:运营的对象在变,运营这件事本身,从未消失。
它是任何与体验、效果相关的应用系统的宿命,只是AI时代,运营的对象从代码,变成了会学习的AI,其中一部分,已经开始承担真实的岗位任务。它对运营的依赖,只深不浅。
那么,一个被业界认识了十几年、被反复警告过的问题,为什么到了AI时代,还是被忽视了?在我看来,比较大的原因有三个。
其一,应用演示驱动的采购。企业立项上AI,能看见的是建设费:平台、模型、应用开发实施,这些写进立项报告。而运营成本,数据链路的人工维护、误报治理的专家时间、知识库的持续更新,在验收后的第一天才开始产生,而且没有预算科目。采购决策由应用演示驱动,应用演示永远不包含运营。
其二,验收文化。很多企业级AI应用项目按合同交付、评审通过验收后,服务商撤出,系统交付给用户单位。但用户单位在使用之外既不会运营、也没有运营所需的人员和经费,导致系统越用越笨,用户不爱用甚至弃用。这不是个别现象:国家发改委网站2026年5月刊发的《以城市智能体建设为抓手创新打造城市“有机生命体”》一文点得很直白,许多智能体项目“重建设、轻运营”,难以持续进化;项目建成后,“模型的迭代优化、数据的持续治理、场景的拓展深化无人负责,导致系统能力停滞甚至退化”。这是整套采购-交付制度的结构问题。
其三,也是最隐蔽的:新技术的光环会周期性清零运营认知。新技术出现伊始,关注度自然会被技术能实现的应用效果吸引,在 “make it work”之前,没人会关注 “make it perform” 和 “make it perform always”,导致运营总是大大滞后于建设,直到大量踩坑撞墙了才开始反思。这是为什么每个时代都不可避免会有“试点炼狱”:IoT时代,麦肯锡的数据说84%的公司试点卡在一年以上;机器学习时代,Gartner说85%的AI项目会产出错误结果;到了生成式AI,MIT的数字是95%。
对工业企业来说,还有一层更特殊的现实:工业AI不只是数据漂移,它的模型变化,必须服从物理约束、生产连续性和安全边界。这是AI进入生产、被现场真正接纳的信任基础;也是为什么,工业AI的运营门槛相对互联网这类不涉及物理安全、物理损失的应用要高得多。
消费类应用AI,漂移是用户行为的渐变,有缓冲。工业AI的漂移原因更多,产线换型了、工艺变更了、设备老化了、传感器退化了、原料批次波动了,每一个都直接打击模型的假设前提。
互联网的数据链路临时中断,用户可以重试;工业的数据链路断了,传感器掉线、工况采集中断,损失的是模型对物理世界这段时间行为的全部感知,而且不可能再来一次。
推荐算法出了错,用户看到不喜欢的内容,划走就是了;工业AI的误报,可能触发一次停机操作,误报治理在车间里是一线信任问题,狼来了效应的代价可能是整个系统被弃用。
互联网的模型可以随时拿新数据重训;工业的再训练要迁就停机窗口、保证产线一致性。同时,工业AI模型的保鲜期可能更短,有行业数据显示,流程工业的预测模型如果不持续再训练,30天内精度可以损失两成,这让再训练问题雪上加霜。
再加上失败的代价不同:互联网AI失败损失体验和收入,工业AI失败损失的是废品、非计划停机,甚至安全事故。
这不是工业界的自说自话。五源资本合伙人孟醒最近关于硅谷的观察文章《当硅谷开始说“打不过国内”》引发广泛讨论,其中一个判断值得工业界注意:AI research正在变宽,设计架构、训模型之后,AI基础设施也算research,到了今天,operation本身也开始进入research的范畴。他还给出一条很有用的尺度:像写代码这样有干净“对错”可验证的场景,人力的边际价值有限;而像视频生成这样没有标准答案、依赖大量人的判断的场景,目标越模糊,human operation的价值越高。
这条尺度放到工业场景,结论只会更强烈。车间里没有一个benchmark能回答“这次工艺调整对不对”,大量判断仍然要依赖老师傅和现场的人,工业AI恰恰是目标最模糊的那一类场景,human operation的价值自然最高。孟醒讲的是模型训练层的运营;而工业AI的实践表明,在应用落地的一侧,同一个逻辑正在重演。
“运营这么重要”,那运营到底指什么?先立一个简单的认知框架:建设,解决“能不能工作”;运维,解决“还在不在工作”;运营,解决“还好不好用”;持续学习,解决“能不能越用越聪明”。
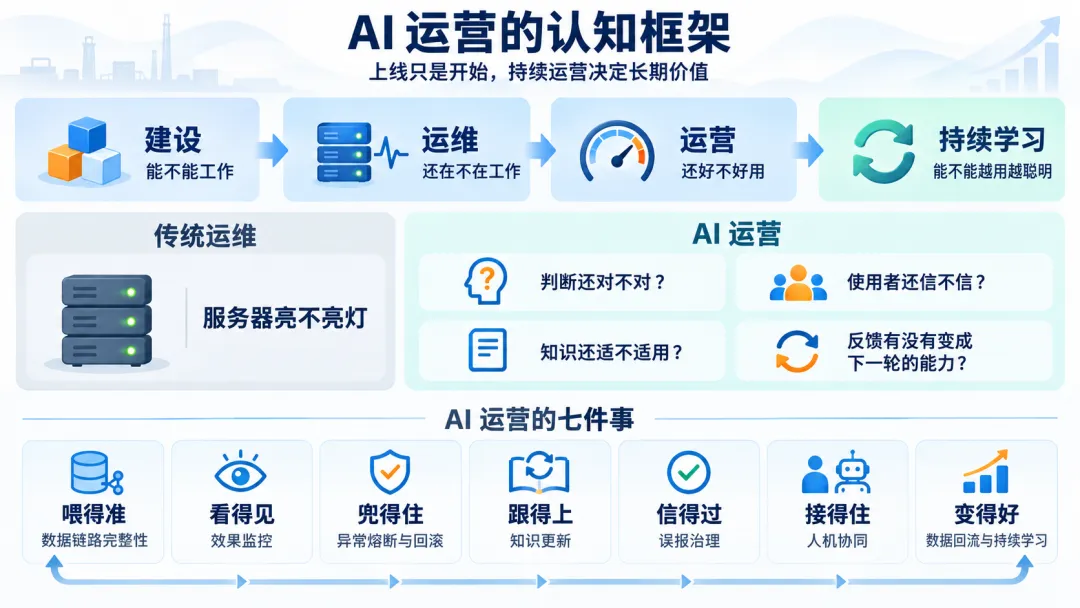
传统运维盯的是服务器亮不亮灯;AI运营要盯的,是一组完全不同的问题,它的判断还对不对?使用者还信不信?知识还适不适用?反馈有没有变成下一轮的能力?
把这组问题拆开,是七件事:喂得准(数据链路完整性)、看得见(效果监控)、兜得住(异常熔断与回滚)、跟得上(知识更新)、信得过(误报治理)、接得住(人机协同)、变得好(数据回流与持续学习)。
讲一个我们自己的一线故事。一个流程制造企业的AI预警系统,上线38天推送了1516次异常预警,误报率15.2%,这个数字显然是打脸。但团队通过运营,把每一次“打脸”都变成系统成长的养料:每一次误报都做闭环跟踪分析,通过运营工具支持,加上与提负面反馈的用户的人工跟进。结果发现,78%的根因不在AI模型,而在输入模型的原始数据和知识不准。针对性治理之后,相关负面反馈从最高频一路降到零。
这就是“AI越用越聪明”的真相:是运营的产出。数据飞轮不会自己转,每一条误报的归因、每一次知识的更新、每一轮模型的再训练,都是有人在运营。那5%跑出来的企业,赢的是这套运营体系。
还有一层可以多说一句:监管其实已经在替运营“立法”。金融行业早把模型持续监控写进合规义务;医药监管允许AI持续改进,但要求厂商把“怎么变好”预先申报、全程留痕。工业AI目前还没有这样的行业规范,但鉴于工业AI在闭环控制等场景下,其可用性、有效性同样敏感,即使没有规范,从业者也需要自觉按这个标准要求自己,同时推动行业规范的形成。谁先把运营体系建到“可审计”的水平,谁就提前拿到了规模化应用的入场券。
从硅谷到工厂,operation(运营)正在重新回到聚光灯下。如果你是正在建AI的企业,这句话值得记住:上线那天,别急着庆祝;真正决定这次投入成败的,是之后你打算怎么养它。
而“怎么养”本身,就是一部不断进化的历史。从DevOps到MLOps、LLMOps、AgentOps,十七年,四个名词,每一代都留下过自己的方法与教训。这段历史,下一篇拆开讲。
再看远一点:一部分AI正从辅助工具,逐步进入业务流程、承担起持续性的岗位任务。当前AI正逐步从“系统”变成“角色”,我们面对的问题也从“如何管理一个AI系统”,变成“如何管理一个AI角色”。
运营,是AI的第一份工作制度;组织,是它的第二份。第一份怎么做实,下一篇细说;第二份怎么定,是更后面的话题。先解决“活下来”,再解决“规模化地活下去”。
Dr. Lu · 2026年9月
关于作者
Dr. Lu,昆仑数据创始人陆薇。虽然是计算机博士,大部分时间不在机房,而在工厂和去工厂的路上。20年来专注一件事:让数据真正理解工业。她是IEEE TCSVC Woman in Services Computing第一位华人女性获奖者,也是最早参与制定中国工业大数据路线图的那批人之一。这个专栏是她在一线的思考——关于工业AI、关于本体模型和控制论、关于AI在工厂落地那些事儿和人。
